2026.08.24
生成AI・LLMアーキテクチャ

昨今のLLM(大規模言語モデル)の普及は目覚ましく、それはしばしば、あらゆるビジネス課題を解決しうる万能の鍵であるかのように語られます。あたかもAIに問いさえすれば、直ちに最適な答えが導き出されるかのような期待が寄せられています。しかしここで、特定の問題に対しては古典的な機械学習のアプローチがいかに高い適合性を示しうるか、そして「制約こそが価値を生む(less is more)」という視点から、その優位性を再考することには大きな意義があります。
ここでの本質的な意図は、LLMの価値を貶めたり、従来型MLの優位性を安易に説いたりすることではありません。むしろ、課題の性質に応じて最適な「道具」を選択すべきである、という基本原則に立ち返ることにあります。LLMは非構造化データの解釈や言語的推論において驚異的な進化を遂げましたが、ビジネスの現場に横たわる課題の多くは、依然として精密な予測や厳格な制約下での最適化を求めています。こうした領域においては、目的を絞った特化型モデルや伝統的な最適化アルゴリズムを用いるほうが、速度・コスト・信頼性、そして評価の透明性という観点から、はるかに優れた適合性を示すことが少なくありません。
私たちが真に向き合うべきは、「いかにしてLLMを導入するか」という手段の議論ではなく、「眼前の課題を解決するために最も信頼できる道具は何か」という問いなのです。
昨今のLLM(大規模言語モデル)の目覚ましい台頭は、ビジネスにおける課題解決のパラダイムを劇的に転換させました。適切な指示さえあれば、コード生成から高度な文書解析、論理的な説明、さらには外部ツールとの連携に至るまで、LLMはあたかもあらゆる問題に対応しうる万能の鍵であるかのように振る舞います。
しかし、その汎用性が、必ずしも個別の課題に対する最適な適合性を保証するわけではありません。
ここで、物流の現場における本質的な問いを再考してみましょう。
この問いは、本質的に言語的推論の範疇ではなく、予測問題に属するものです。
導き出されるべき解は、過去の実績値や地域特性、時間軸、季節変動、さらには気象条件といった構造化されたシグナルの蓄積に依存しています。ここでの目的は、厳格な指標に基づき評価・改善が可能な、精密な予測値を算出することにあります。
予測が次なる実務上の意思決定と直結する場合、この正確性は決定的な意味を持ちます。需要を過小に評価すればリソース不足を招き、逆に過大な見積もりは不必要なコストの増大を強いることになります。いずれの乖離も、ビジネスにおける効率性を著しく損なう要因となりうるのです。
こうした局面で真に問われるべきは、その手段にLLMを用いることが可能かどうかではありません。
その解がLLMではない局面も確実に存在します。そうした場合には、漫然と最新技術を適用するのではなく、本質的な調査にリソースを割くべきです。計算資源や時間的オーバーヘッドを最小化し、ビジネス価値を最大化しうる最適解の探究にこそ、真に知的な時間を投じる意義があります。
実例を挙げれば、病床需要予測のような時系列のトレンド解析においては、汎用的なLLMよりもサポートベクター回帰(SVR)のような古典的MLのほうが、遥かに優れた適合性を示すことが少なくありません。それは、当該システムが特定の入力構造に対して設計されており、極めて高い予見可能性と一貫性を備えているからです。
先述の病床需要予測は、一見すれば単一の事例に過ぎないかもしれません。しかし、ビジネスの根幹において、予測という営みが依然として決定的な重要性を帯びている点を見落としてはなりません。たとえ売上や収益といった計数値を算出するだけの簡素なモデルであっても、それは最適なリソース配分や戦略的な意思決定を支える、極めて実効性の高い「地図」となり得るのです。
ここでの本質は、こうした課題が厳格に定義された「構造化された予測問題」であるという点にあります。過去の蓄積されたシグナルを入力とし、次月の売上見込みや顧客離脱の蓋然性といった、明確に測定可能な解を導き出すこと。その出力の品質は、MAEやRMSE、あるいは適合率、再現率、AUCといった厳密な指標によって客観的に評価し、継続的な改善サイクルを回すことが可能です。
予測という営みが「将来の蓋然性」を見積もるものであるのに対し、スケジューリング問題の本質は、提示された多種多様な制約条件下において、有限の資源をいかにして最適に配分するかという問いにあります。
例として、医療現場における勤務シフトの策定を想起してみましょう。そこには、膨大な人数のスタッフ、多層的な時間枠、高度な専門スキル、法定労働時間の遵守、個々の休暇申請、そして安全性を担保する人員基準といった、複雑に絡み合う制約が存在します。ここでの目的は、これらすべての境界条件を厳格に満たしつつ、経済的合理性や運用効率を極限まで追求した「解」を導き出すことに他なりません。
こうした課題は、航空、製造、物流といったあらゆる産業に偏在しています。乗務員の割り当て、生産ラインの稼働計画、車両の配送ルート策定。いずれの局面においても、問題の規模が拡大するにつれて、探索すべき組み合わせの数は指数関数的に増大し、人間の直感を超えた複雑な領域へと突入します。
もちろん、LLMを用いて「もっともらしい」スケジュールを出力させることは可能です。しかし、表層的な妥当性と、数学的な有効性(validity)や最適性は決定的に異なります。労働時間の微かな超過やリソースの重複といった、たった一つの制約違反が、計画全体を実務上の「不能」へと陥れるリスクを孕んでいるのです。
ここに、言語的推論と数理最適化の決定的な境界線があります。LLMが確率的なパターンに基づきもっともらしい応答を合成するのに対し、最適化アルゴリズムは明示的に定義された目的関数と制約を軸に、厳密な解を探究するように設計されています。
LLMの魅力はその汎用性にあります。単一のモデルが、文書を要約し、コードを書き、質問に答え、データを分析し、ユーザーと対話することができます。個々のタスクごとに別々のシステムを構築することと比べれば、これは明らかな利点に見えます。
しかし、汎用性にはコストが伴います。本番環境で問われるのは、モデルがそのタスクを実行「できるか」だけではなく、大規模な運用において、信頼性高く、効率的に、そして経済的に実行できるかという点です。
LLMを漫然と実務に適用することは、リソースの浪費とコストの劇的な増大を招きます。たとえば、デイリーで数百万件規模の推論を要求されるビジネス環境においては、ユニットコストの僅かな乖離が、長期的には看過し得ない財務的負担へと変貌するのです。
また、独自のインフラ上でモデルを運用する選択肢も、多大なハードウェア投資を強います。GPUやメモリといった計算資源の需給が逼迫する昨今、全社規模でのLLM運用を経済的合理性の範囲内で構築することは、極めて困難な挑戦となります。
さらに本質的な課題は、汎用LLMが特化型モデルと比較して、応答速度において劣り、かつ出力の信頼性において不安定さを露呈しうる点にあります。特定のタスクに最適化された「道具」を選択することこそが、実行の確実性を担保し、ビジネス価値を最大化する最短経路となるのです。
LLMを実務に組み込む際、私たちが直面する不可避なコストの一つは、極めて本質的な問いに集約されます。
現在、ビジネスにおけるLLM運用の多くは、外部プロバイダのAPIに依存しています。たとえエンタープライズ向けの堅牢な管理機能が備わっていたとしても、自社データと推論エンジンの間に第三者の介在を許す事実は変わりません。機微な情報を守るべき組織にとって、データレジデンシーや保持期間、厳格なアクセス制御、そしてコンプライアンス上の第三者リスクは、看過できない経営課題となります。
患者の診療記録を解析する医療機関や、膨大な決済情報を扱う金融プラットフォームを想起してください。外部モデルへのデータ送信は、同意取得や暗号化、監査、さらには契約上の厳格な義務を伴います。もはや論点は「モデルの回答精度」に留まらず、組織として「適正なデータ管理をいかに実証するか」という、証明責任の領域へと移っているのです。
加えて、API経由で提供された情報が意図せず学習プロセスに取り込まれるリスクにも、細心の注意を払わねばなりません。万が一、他者のプロンプトに対する応答として機密が露出すれば、それは致命的な情報漏えいへと直結します。
LLMという技術が未だ発展途上である以上、悪意ある攻撃に対しても脆弱性を孕んでおり、データ保護をめぐる挑戦は日々その複雑さを増しているのです。
汎用性は速度を犠牲にすることもあります。
多くの業務システムは、厳しいレイテンシ要件のもとで稼働しています。不正検知は、取引が承認される前に完了しなければならないかもしれません。異常検知は、センサーデータが到着するそばから行わなければならないかもしれません。物流システムは、状況の変化に応じて数千のルートを再計算しなければならないかもしれません。
こうした状況では、ミリ秒単位で予測を返す特化型モデルのほうが、応答に大幅な時間を要する巨大なモデルよりも有用でありえます。
もう一つの隠れたコストが、評価です。
従来型の予測モデルであれば、目的変数を定義し、MAE、RMSE、適合率、再現率、AUCといった指標で性能を測定できます。そのため、新しいモデルが従来のものより優れているかどうかを判断するのは比較的容易です。
LLMの場合、出力が開放的(open-ended)であるとき、評価ははるかに複雑になりえます。ある説明は別の説明より優れているのか。生成された要約は網羅的か。モデルは重要な詳細を見落としていないか。元の資料になかった情報を混入させていないか。
これはLLMが不適切だということではありません。ただ、それが正しく機能していることを証明するコストが相当に高くつきうる、ということです。
モデルの汎用性が生む費用の中で、とりわけ見落とされがちなのが「自社では活用しない過剰な能力に対価を支払う」という無駄です。
たとえば、取引データの分類や需要予測、異常探知といった特定の業務のみを求める場合、高度な文章執筆や概念の解説を行う能力は、実務上の直接的な価値をほとんど生み出しません。
これは、一本のドライバーで済む作業に対し、多機能な十徳ナイフを買い求めるようなものです。備わっている機能の多さは魅力的に映るかもしれませんが、それによって作業の質や効率が向上するとは限りません。
したがって、現場で成果を出すAIシステムを構築する際に優先すべきは、全コンポーネントのスペックを最大限高めることではなく、課題を確実に解決しうる最小限の複雑さに留めることです。
汎用モデルが真価を発揮するのは、対象とする課題自体が多角的な場合です。もし取り組むべき問題が明解に絞られているのであれば、その領域への特化こそが強力な競合優位性となり得ます。
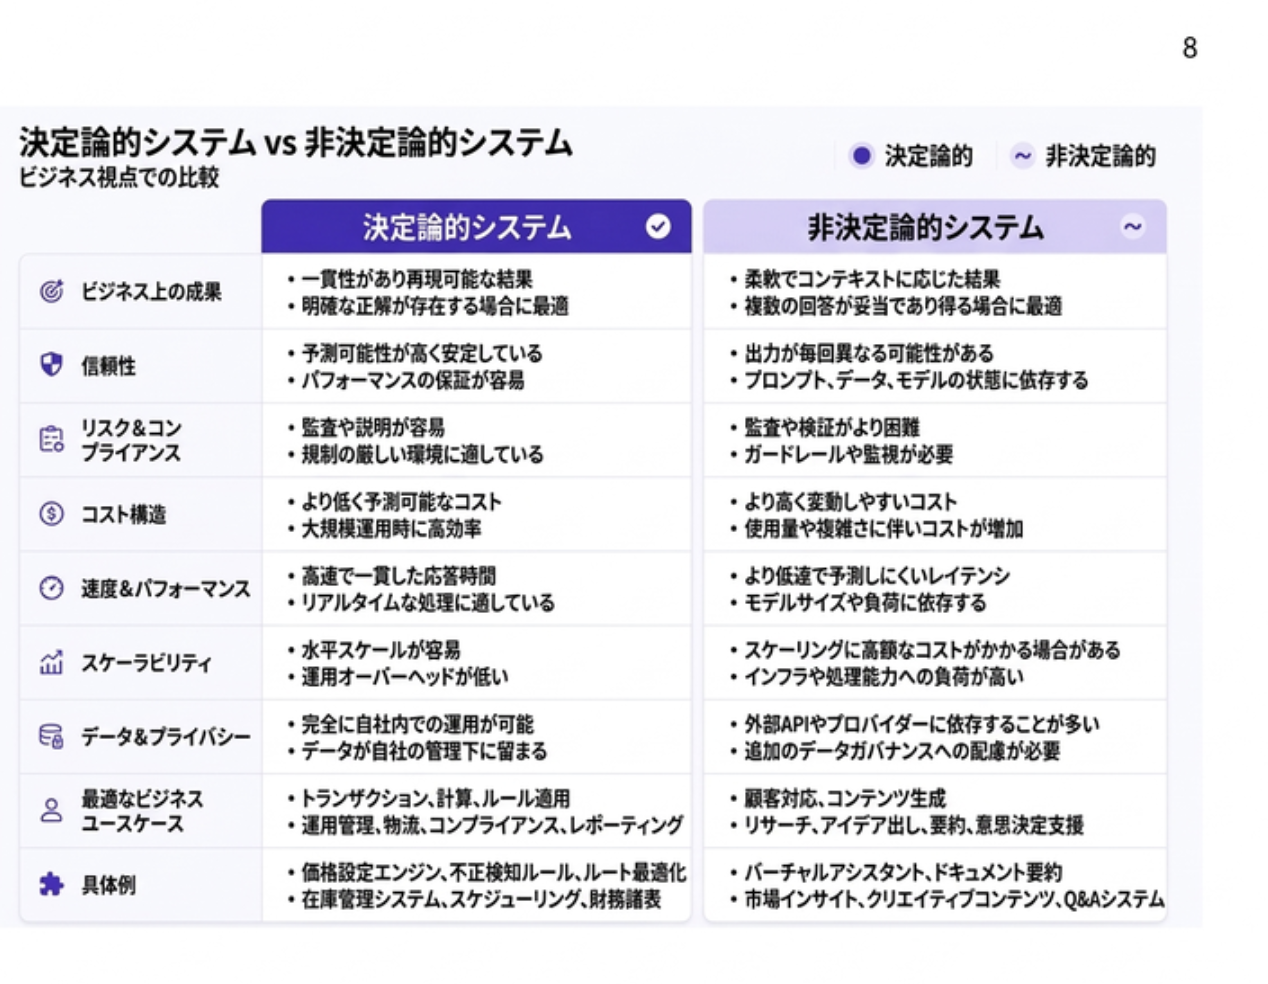
従来型のロジックとLLM中心のアーキテクチャとの大きな違いの一つは、出力をどの程度予測可能なものとして扱えるかという点にあります。
システムが決定的(deterministic)であるとは、同じ入力を同じ条件で処理した場合に、常に同じ結果が得られることを指します。たとえば、注文金額の計算を考えてみてください。ルールとデータが同じであれば、何度実行しても結果は変わりません。
ただし、通常のソフトウェアと、機械学習や最適化アルゴリズムは分けて考える必要があります。古典的MLやソルバーアルゴリズムも、実務上は必ずしも完全に決定的とは限りません。アルゴリズムの選択、設定、乱数シード、推論パラメータなどによって、結果が変わる場合があります。それでも、こうした特化型システムの強みは、目的、制約、性能指標を明確に定義し、厳密に評価できることにあります。
一方、LLMは異なる性質を持っています。LLMは本質的に確率的なシステムであり、学習データとプロンプトの文脈からパターンを捉え、応答を生成します。そのため、同じ目的のタスクであっても、使用するモデルやサンプリング設定によって、生成される内容が変わることがあります。
しかし、このばらつきは必ずしも欠点ではありません。むしろ、この柔軟性こそがLLMが言語的なタスクで力を発揮する理由の一つです。報告書の要約、概念の説明、顧客との対話などには、必ずしも一つの正解があるわけではありません。状況に応じて異なる表現や回答が成立するからです。
問題になるのは、この柔軟性を、均一性や厳格な制約、予測可能な結果が求められるタスクに適用する場合です。
たとえば、物流システムでドライバーの勤務時間が法定上限を超えていないかを確認したり、金融システムで決められた計算式に基づいて金額を算出したりするケースを考えてみてください。こうした場面では、解が明確な条件を満たしていることが重要です。そのため、システムの動作を厳密に制御し、測定・検証できることが求められます。
こうした領域では、特化型モデルや従来型ソフトウェアが大きな強みを発揮します。これらは必ずしも完全に決定的ではありませんが、管理された環境の中で制約を設定し、性能を評価し、結果を再現することが比較的容易です。
とはいえ、決定性が常に優れているわけではありません。たとえば、カスタマーサポートのような対話型システムでは、会話の文脈に応じて異なる回答を返すほうが、より自然で効果的な場合があります。人間とのやり取りでは、同じ入力に対して常に同じ出力を返すことよりも、状況に応じて柔軟に対応できることが重要になるからです。
重要なのは、決定的なシステムと確率的なシステムのどちらが優れているかではありません。問題に応じて、必要な制御性と柔軟性のバランスを選ぶことです。
唯一の正解が存在する場合や、厳格な制約を守る必要がある場合には、予測可能性が重要になります。一方、複数の解が成立し、文脈に応じた対応が求められる場合には、柔軟性そのものが価値になります。